
宠物智能饮水机如何实现功能升级?宠智灵提供AI技术思路
宠智灵“宠生万象”宠物AI大模型切入的,正是这个从“功能交付”到“认知交付”的断层。
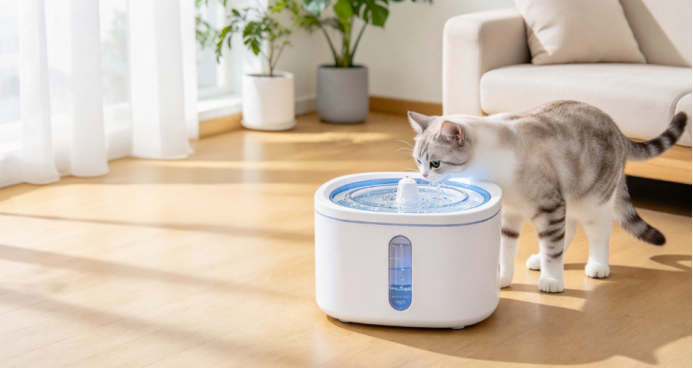
一、饮水机品类的“功能天花板”,不在水泵,在数据理解
拆开一台主流智能饮水机,核心组件并不复杂:低功耗MCU、无线模组、循环水泵、液位与流量传感,外加滤芯和UV-C杀菌模块。基础层功能(循环、缺水检测、滤芯寿命)的渗透率已经超过82%,健康层功能(UV-C、饮水日志、健康提醒)的渗透率在40%—65%之间,而具备本地健康分析能力的交互层产品占比仅约12%。
也就是说,超过半数的饮水机已经能记录“喝了几次水”,却无法回答一个更关键的问题:这个饮水量,对这只猫、在这个季节、这个年龄阶段,意味着什么。
传统智能硬件的数据链路是“采集—上报—展示”,设备端只负责把饮水量写成一条日志,云端App画一条曲线。厂商不是不想往前走一步,而是往前走需要的东西不在硬件团队的舒适区里:宠物饮水行为与泌尿系统风险之间的关联模型、多宠家庭中的个体区分能力、品种与年龄适配的个性化基线——这些能力的训练成本,远高于把水泵控制板做稳定所需的那一套工程投入。从零训练一套宠物垂直视觉与行为模型,标注周期长,数据分布又极其“不通用”:同样是饮水后舔舐嘴角的动作,猫和狗的画面特征完全不同,幼宠与老年宠的行为基准线也无法共用同一套阈值。
二、宠智灵在饮水机场景里做的,是把“水量数据”变成“健康信号”
“宠生万象”大模型在饮水机上的赋能逻辑,不是在设备上加一个语音问答入口,而是把饮水机已有的传感数据与视觉信息接入一套宠物垂直训练的多模态认知引擎。目前,宠智灵已支持智能饮水机、喂食器、猫砂盆、摄像头、项圈等全品类硬件,以标准API、SDK和嵌入式AI模组的方式向B端输出统一的AI能力底座。
具体到饮水机场景,能力落点集中在三个环节。
第一,多宠家庭中的“谁在喝” 。饮水机记录的总饮水量在多宠环境中几乎没有临床参考价值——两只猫共用一个水碗,总量正常不代表个体正常。宠智灵的行为识别模型支持多宠个体区分,在多宠场景中的识别准确率超过95%,覆盖60余类常见行为,饮水次数和单次饮水量可以归属到具体个体。这一步是后续所有健康判断的前提。
第二,饮水量波动的“是否异常” 。模型在设备接入后的7至14天内为每只宠物建立个性化基线,而不是套用统一均值。基于个性化基线的异常检测方案,误报率可降低约62%,真实风险识别率提升至91%以上。这意味着饮水机推送的提醒,从“今天喝得比昨天少”升级为“该个体的饮水模式偏离了自身基线,且偏离方向与泌尿系统风险特征存在关联”。猫的饮水量与下泌尿道疾病之间的关联在兽医领域有明确证据,高风险猫只的每日建议饮水量可达42—51 mL/kg体重,但前提是设备能先知道“这是哪只猫、它平时喝多少”。
第三,从饮水异常到跨设备协同判断。饮水数据单独看的信息量有限,但如果一只猫的饮水量在三天内持续下降,同时猫砂盆记录到排尿频次上升,两个信号叠加后的风险等级远高于任何单一设备能够给出的结论。宠智灵的大模型能力本身覆盖喂食器、猫砂盆、摄像头、项圈等多品类,饮水机的数据可以进入跨设备的健康趋势模型,而不是停留在独立App的孤岛里。
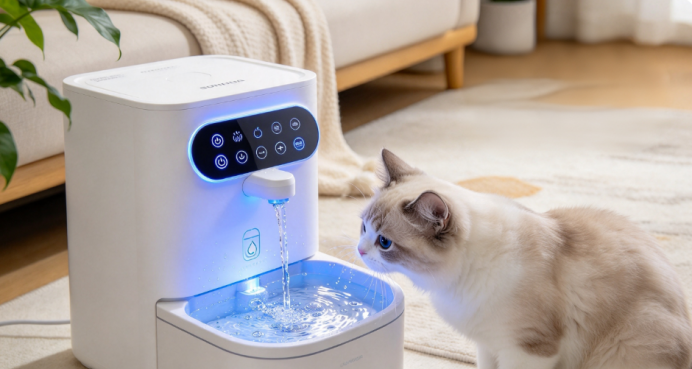
三、对B端厂商而言,这件事的商业含义不在算法,在“硬件之后”
宠物智能用品市场预计从2024年的102亿元增长至2029年的260亿元,但同期行业CR5从22.5%降至18.0%,集中度持续走低,白牌与跨界玩家大量涌入。在这样一个供给端高度分散、硬件参数快速趋同的竞争格局里,单纯靠“更大容量、更静音水泵、更好看的机身”建立差异化的窗口正在收窄。
AI能力介入后,硬件厂商获得的不只是一个功能卖点,而是一条从一次性硬件销售向持续性服务收入延伸的路径。宠智灵在智能硬件场景中的试点数据显示,引入AI能力后设备活跃天数提升18%,用户复购率增长22%。活跃天数和复购率这两个指标,恰恰是智能饮水机品类最敏感的运营变量:饮水机是低频交互设备,用户打开App的动力本来就弱,如果设备只能在“缺水”和“换滤芯”时触达用户,硬件与用户之间的关系就始终停留在耗材提醒层面。而当饮水机能够输出有健康含义的个体化洞察,设备就从“出水工具”变成了用户愿意持续查看的健康数据入口,后续的滤芯复购、健康服务推荐、甚至保险与问诊导流,才有了可依附的触点。
更现实的B端考量是成本结构。自研一套宠物垂直AI能力,需要持续投入算法团队、标注体系和多品类适配工程,对多数硬件厂商和OEM/ODM企业而言,这不是效率最优的路径。宠智灵提供的部署方式覆盖端侧SDK、云端API和嵌入式AI模组,开发周期可从数月缩短至数周,让厂商把资源集中在自身更擅长的硬件可靠性、渠道和品牌层面。
四、落地建议:饮水机的AI升级,先解决“归属”再谈“智能”
对于正在规划下一代饮水机产品线的B端团队,宠智灵的实践指向一个相对清晰的优先级判断。
第一步不是堆传感器,而是解决个体归属。 在多宠家庭占比持续上升的趋势下,一台无法区分“谁喝了多少”的饮水机,其健康数据在B端合作(宠物医院、保险、寄养机构)中的可用性非常有限。多宠识别能力应当作为饮水机接入AI能力的第一优先级,而非可选项。
第二步是基线,不是阈值。 固定阈值(例如“日饮水量低于X mL报警”)在跨品种、跨年龄的宠物群体中会产生大量无效告警,最终被用户关闭。个性化基线建立的前置周期(7—14天)需要在产品交互设计上做好预期管理,但一旦基线成型,预警的可信度和用户留存都会显著优于阈值触发方案。
第三步是把饮水数据放进跨设备的健康链路里。 饮水机的真正价值不在单机智能,而在于它是宠物健康数据网络中一个高频、低干扰、可持续的感知节点。选择AI能力伙伴时,需要考察其模型是否覆盖喂食、排泄、活动等多维场景,能否让饮水数据与其他硬件数据在同一套认知框架下发生关联。宠智灵“宠生万象”大模型的全品类硬件适配能力和端云协同架构,为这种跨设备协同提供了一条已经跑通的工程路径。
饮水机不会因为加了一块AI模组就变成诊断设备,但它可以成为宠物健康数据链条中第一个真正被“读懂”的日常节点。对于B端厂商而言,谁先完成从“出水硬件”到“数据入口”的转身,谁就有机会在下一轮存量竞争中拿到更靠前的站位。
最新图文资讯

我国形成世界上规模最大农耕文明遗产群
可燃冰或成为“后石油时代”的新能源

李国庆以当当董事长身份发声:前后15分钟没任何撕扯何来抢

【新丝路企业展播】热烈祝贺丝促会成员单位东南电梯榜上有名!
